
Pendant que Nvidia vend des GPU devenus si puissants qu’ils imposent parfois de revoir l’alimentation électrique, le réseau et le refroidissement d’un data center entier, Fujitsu choisit une trajectoire presque provocatrice.
Pas de nouveau monstre graphique.
Pas de promesse naïve de « GPU killer ».
À la place, le japonais prépare MONAKA, un CPU Arm de 144 cœurs gravé en 2 nm là où cela compte, pensé pour exécuter une partie de l’IA sans carte graphique dédiée. Pas toute l’IA. Et c’est justement ce qui le rend crédible.
Le mot « sans GPU » cache une nuance immense
Faire tourner de l’IA sans GPU n’a rien de miraculeux.
Un LLM quantifié peut déjà fonctionner sur CPU. Llama.cpp existe pour cela. Des modèles de vision, de classification, de transcription ou de recherche sémantique tournent depuis longtemps sur des processeurs classiques. Le problème n’a jamais été la possibilité. Le problème, c’est le rapport entre le débit, la latence, l’énergie consommée et le coût total du serveur.
Fujitsu MONAKA arrive exactement dans cette zone grise, celle que l’industrie préfère parfois ignorer parce qu’elle fait moins rêver qu’un rack rempli de GPU. Le processeur est destiné à l’inférence IA sur CPU, au cloud, au calcul scientifique, aux bases de données et aux environnements où les charges alternent calcul, accès mémoire, recherche de documents, appels d’API et logique métier. Fujitsu l’intègre aussi dans une stratégie plus large de serveurs souverains conçus et fabriqués au Japon. La communication officielle de Fujitsu sur ses serveurs souverains le place clairement dans cette logique d’infrastructure critique.
La distinction est fondamentale.
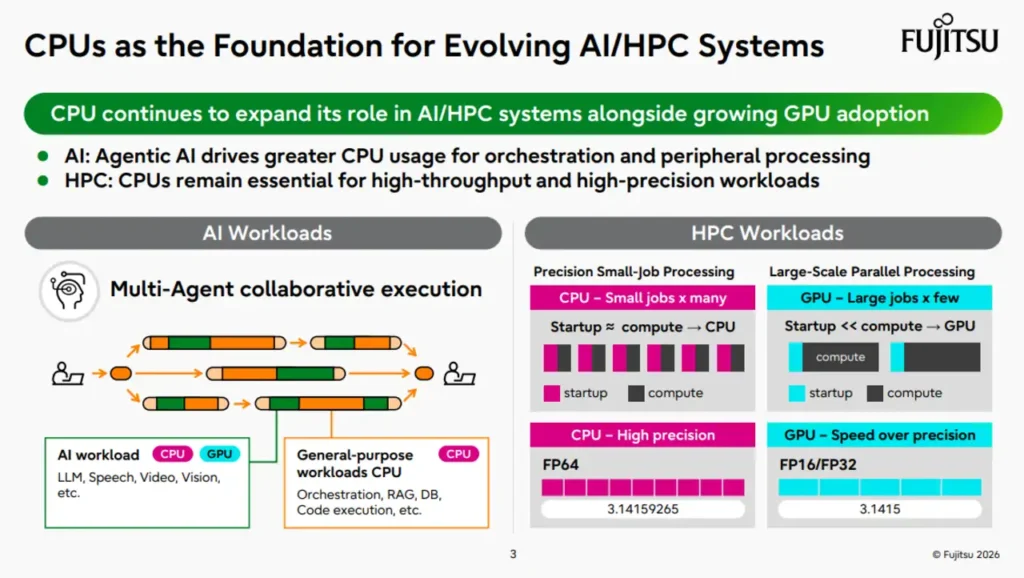
Un GPU excelle quand il faut faire énormément de calcul matriciel, très vite, sur de larges lots de données. C’est idéal pour entraîner des modèles massifs ou servir un très grand nombre de requêtes sur des LLM lourds. Mais un agent IA d’entreprise n’est pas un benchmark. Il passe son temps à chercher un document, interroger une base SQL, vérifier un droit d’accès, appeler un outil, puis générer trois phrases.
Le GPU peut alors devenir une réponse excessivement coûteuse à une question mal posée.
Et si le problème n’était pas que vos serveurs IA manquent de puissance, mais qu’ils embarquent de la puissance au mauvais endroit ?
MONAKA ne joue pas selon les règles de Nvidia
Le CPU Fujitsu MONAKA repose sur l’architecture Armv9-A et embarque 144 cœurs par socket, jusqu’à 288 cœurs dans une machine bi-socket. Il propose deux unités vectorielles SVE2 de 256 bits par cœur, des capacités de calcul matriciel destinées à l’IA et au HPC, 12 canaux de DDR5 et une connectique PCIe 6.0 avec CXL 3.0. Ce n’est pas un processeur serveur banal auquel on aurait ajouté un autocollant « AI ready ». Les documents techniques de Fujitsu confirment notamment les 144 cœurs, l’Armv9-A, le SVE2-256, les 12 canaux DDR5, le PCIe 6.0 et le CXL 3.0.
Il faut être net : MONAKA ne remplacera pas les GPU Nvidia dans les très gros modèles de langage.
Une IA générative de grande taille exige une bande passante mémoire gigantesque. Elle doit relire continuellement ses poids, parfois répartis sur plusieurs accélérateurs, et servir de nombreux utilisateurs à faible latence. Sur ce terrain, la mémoire HBM, les interconnexions NVLink et les logiciels optimisés de Nvidia restent difficiles à contourner.
Mais voilà l’erreur courante : croire que chaque déploiement IA ressemble à ChatGPT à l’échelle mondiale.
La majorité des entreprises n’entraînent pas de modèle frontière. Elles déploient des modèles plus petits, quantifiés, spécialisés ou adossés à leurs propres données. Elles cherchent un serveur IA sans GPU pour garder une information en interne, limiter la consommation, éviter la dépendance à un fournisseur unique ou installer un système dans un site qui ne supporte pas un refroidissement liquide.
MONAKA vise ce marché-là.
Fujitsu ne dit pas : « nous sommes plus forts que Nvidia partout ». Il dit plutôt : « pour une partie des workloads, vous n’aurez peut-être pas besoin d’acheter un GPU ». C’est beaucoup moins spectaculaire sur une miniature YouTube. C’est peut-être bien plus dangereux pour le modèle économique des accélérateurs sur le long terme.
Le vrai coup de force est sous les cœurs
Le mot-clé « 2 nm » attire l’œil, évidemment. Pourtant, la gravure n’est pas l’information la plus intéressante.
La vraie singularité de Fujitsu MONAKA est son architecture 3D. Les dies contenant les cœurs de calcul sont gravés en 2 nm, tandis que la SRAM et les fonctions d’entrées-sorties sont placées sur des dies distincts gravés en 5 nm. Le calcul est littéralement empilé sur la mémoire cache. Une construction en sandwich, oui, mais un sandwich qui évite de gaspiller les procédés les plus coûteux sur des blocs qui ne profitent pas autant de la miniaturisation. La présentation ISC 2026 de Fujitsu décrit cette conception par chiplets 3D, combinant core die, SRAM die et I/O die.
C’est un choix plus malin que glamour.
Le standard du marché serait de graver le plus possible avec le procédé le plus avancé disponible, puis de vendre le chiffre comme une médaille. Fujitsu fait l’inverse : il réserve le 2 nm aux transistors qui en tirent vraiment avantage, les cœurs de calcul, tout en conservant la SRAM et les I/O en 5 nm. L’entreprise indique que le 2 nm représente moins de 30% de la surface totale de silicium, ce qui réduit le coût, limite l’exposition aux défauts de fabrication et améliore le rendement industriel. Les détails publiés autour de MONAKA expliquent cette séparation entre calcul en 2 nm et SRAM/I/O en 5 nm.
Ce n’est pas une concession technique. C’est la stratégie.
J’ai déjà vu ce scénario dans les comparatifs de processeurs grand public : tout le monde fixait la finesse de gravure, très peu regardaient la quantité de cache, la bande passante mémoire ou l’architecture interne. Puis les tests réels arrivaient et le produit « moins avancé » sur la fiche marketing s’avérait plus cohérent dans les usages quotidiens.
La leçon est brutale : une technologie ne devient pas meilleure parce que son nombre est plus petit.
MONAKA ne cherche pas à battre un record de marketing en 2 nm. Il cherche à rapprocher physiquement les cœurs et le cache, à réduire les mouvements de données, à augmenter la densité de calcul et à contenir l’explosion énergétique. C’est moins simple à expliquer. C’est aussi beaucoup plus sérieux.
La DDR5 n’est pas de la HBM, et alors ?
MONAKA intègre 12 canaux de DDR5, avec un support annoncé jusqu’à 8 800 MT/s. Sur le papier, cela représente une bande passante théorique de l’ordre de 844 Go/s par socket. Fujitsu évoque plutôt un ordre de grandeur pratique autour de 500 Go/s, selon les charges et la capacité à exploiter effectivement l’interface mémoire. La fiche technique Fujitsu dédiée à MONAKA positionne le processeur comme une plateforme Arm orientée performances et efficacité énergétique pour les data centers de nouvelle génération.
Soyons honnêtes : ce n’est pas de la HBM.
Une puce Nvidia haut de gamme dotée de mémoire HBM joue dans une autre catégorie de bande passante. Elle est conçue pour nourrir des milliers d’unités de calcul massivement parallèles. Un CPU IA comme MONAKA ne peut pas simuler cette réalité en ajoutant simplement des cœurs Arm et de la DDR5 très rapide.
Mais faut-il de la HBM pour chaque service IA ?
Non. Et c’est ici que l’obsession du « plus gros modèle possible » commence à coûter cher. Pour un RAG interne, un moteur de recherche sémantique, une extraction de données, une IA de contrôle qualité, une analyse documentaire, un outil de support client ou un agent qui consulte plusieurs systèmes métier, l’architecture entière compte davantage que le seul débit de calcul matriciel.
Le serveur doit surtout être constant.
Il doit pouvoir exécuter le modèle, gérer les bases de données, conserver les données sensibles sur site, traiter les requêtes, orchestrer les outils et tenir la charge sans transformer une salle informatique en problème thermique. Fujitsu avance d’ailleurs MONAKA comme une plateforme pouvant répondre à des infrastructures sensibles à l’efficacité énergétique et à la souveraineté des données, deux arguments qui prennent une dimension concrète pour les administrations, l’industrie ou la finance.
Fujitsu présente MONAKA dans sa stratégie d’IA fiable et durable.
Ce n’est pas la bande passante maximale qui compte toujours.
C’est celle qui évite de payer une infrastructure démesurée pour servir un modèle raisonnable.
Deux fois moins de serveurs ? Méfiance, mais pas cynisme
Fujitsu affirme que MONAKA peut réduire le nombre de serveurs nécessaires dans certains déploiements d’IA. Le chiffre est séduisant. Il mérite d’être cité, mais jamais répété comme une vérité générale.
Deux fois moins de serveurs par rapport à quoi ?
Face à un serveur CPU ancien ? Face à un cluster équipé de GPU surdimensionnés ? Avec un modèle quantifié en 4 bits ou un modèle dense en pleine précision ? À quelle longueur de contexte, quel nombre d’utilisateurs simultanés, quelle latence exigée, quelle puissance électrique disponible et quel système de refroidissement ?
Sans ces variables, une annonce de performance est une direction. Pas encore une preuve.
L’erreur classique consiste à comparer le prix d’un GPU au prix d’un CPU. Ce calcul ne vaut rien. Il faut comparer une solution complète : le serveur, la mémoire, le stockage, les cartes réseau, le refroidissement, l’électricité, les licences, les opérations, la disponibilité et le coût de maintenance. Un GPU peut gagner très largement sur les tokens par seconde, tout en devenant mauvais économiquement si la charge réelle ne justifie pas sa présence.
J’ai déjà participé à ce genre de calcul. Sur le papier, le GPU gagnait tous les benchmarks. Dans le budget annuel, il perdait parce que le projet devait rester actif 24 heures sur 24 pour quelques dizaines de requêtes par minute. La machine passait plus de temps à attendre qu’à calculer. Nous avions acheté la vitesse avant de mesurer le trafic.
Cette fois, le mot « innovation » avait surtout servi à cacher une erreur de dimensionnement.
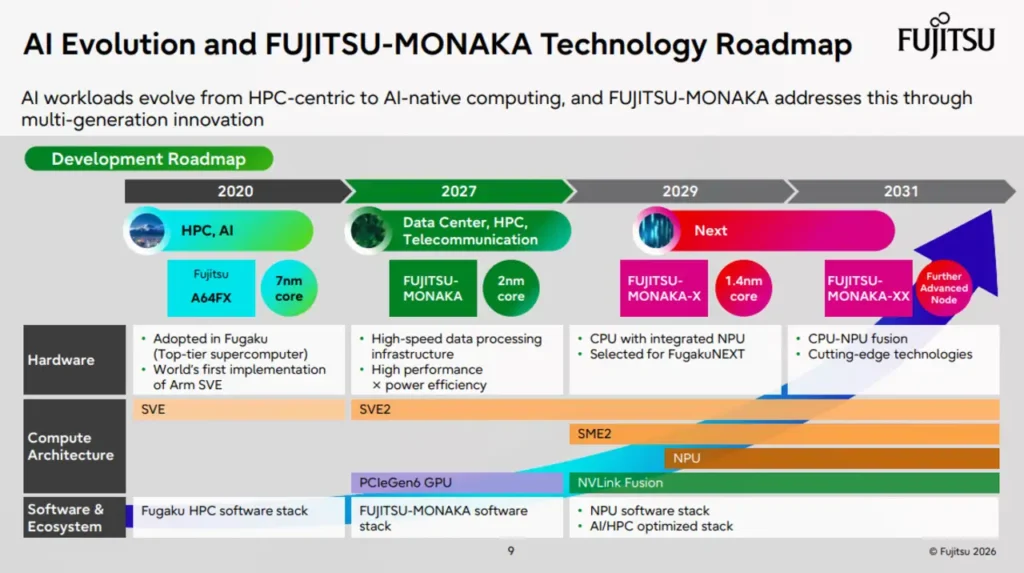
La promesse de MONAKA devient donc crédible lorsqu’elle est formulée correctement : il pourrait réduire le nombre de serveurs ou l’énergie nécessaire pour des charges d’inférence précises, là où une plateforme CPU dense et efficace remplace une infrastructure hétérogène ou suréquipée. Fujitsu prévoit de commercialiser ses processeurs et serveurs MONAKA à partir de novembre 2026, avec une montée en disponibilité matérielle au cours de 2027. L’annonce de commercialisation relayée après le communiqué Fujitsu évoque cette mise sur le marché progressive.
Le conditionnel n’affaiblit pas l’annonce.
Il lui donne une colonne vertébrale.
L’IA n’a pas besoin d’un GPU partout
L’avenir ne se résume pas à CPU contre GPU. Ce duel est confortable, mais il est faux.
Les GPU conserveront leur domination pour l’entraînement des modèles géants, l’inférence à très grande échelle et les applications qui exigent le maximum de calcul matriciel. Nvidia n’a pas seulement construit des puces : l’entreprise a construit un écosystème logiciel, des bibliothèques, des interconnexions et une habitude de marché. Cela ne se remplace pas avec une belle fiche technique.
Mais l’IA d’entreprise qui arrive maintenant est différente. Elle est plus locale, plus réglementée, plus connectée aux données métiers, parfois moins spectaculaire et souvent plus rentable. Elle tourne avec des modèles spécialisés, des agents, des workflows documentaires et des systèmes hybrides. Dans ce monde-là, un CPU pour IA capable de combiner calcul vectoriel, mémoire rapide, densité de cœurs et efficacité énergétique devient une alternative crédible.
Fujitsu MONAKA ne signe pas la mort du GPU.
Il pose une question beaucoup plus gênante : combien de GPU sont aujourd’hui achetés parce qu’ils sont indispensables, et combien sont achetés parce que personne n’a pris le temps de vérifier si un CPU vraiment pensé pour l’inférence pouvait suffire ?
Le marché de l’IA ne manque pas de puissance.
Il manque surtout de discernement.